
¿Su sistema automatizado está filtrando datos? Lecciones del incidente de una cafetera de 1TB
Descubra cómo los sistemas automatizados consumen recursos y cómo las auditorías de datos y los controles por lotes mantienen la estabilidad operativa.
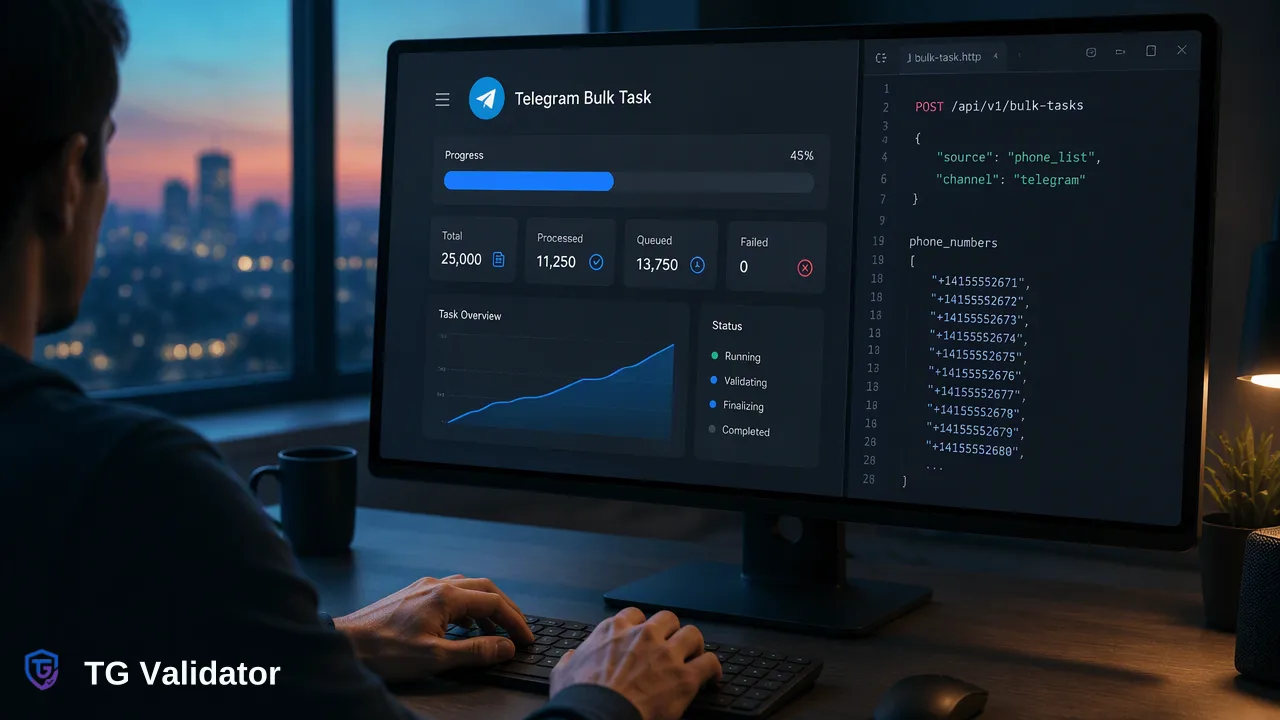
La automatización sin supervisión puede consumir recursos masivos de forma silenciosa. Aprenda cómo las auditorías de datos y los flujos de trabajo estructurados por lotes mantienen bajo control las tareas de gran volumen.
El incidente viral relacionado con una cafetera inteligente que transmitió 1TB de datos en 10 días ilustra los riesgos operativos ocultos de los sistemas automatizados sin supervisión. En la infraestructura empresarial, los flujos de trabajo automatizados, como el sondeo continuo de datos, la validación de listas de contactos y las integraciones de API, pueden consumir silenciosamente la capacidad de la red y las reservas de saldo si no se controlan. La implementación de prácticas regulares de auditoría de datos, la separación de las solicitudes síncronas en tiempo real del procesamiento estructurado de lotes asíncronos y el seguimiento del progreso de las tareas ayudan a las organizaciones a mantener la visibilidad y el control sobre las operaciones automatizadas.
Los riesgos operativos de la automatización de "configurar y olvidar"
Un informe técnico reciente documentó que un profesional de TI descubrió que la cafetera conectada a Internet de sus padres había generado 1TB de tráfico de red en solo 10 días. Aunque el dispositivo no transmitió los datos externamente, la emisión interna descontrolada saturó el punto de acceso Wi-Fi local, degradando la estabilidad de la red doméstica. El incidente se debió a una anomalía de software que transmitía paquetes continuamente sin control.
Para los equipos técnicos empresariales, este escenario demuestra la rapidez con la que los scripts automatizados sin supervisión pueden degradar la infraestructura. En los flujos de trabajo de mensajería automatizada, verificación y canalización de datos, los procesos descontrolados rara vez se anuncian con fallos inmediatos. En su lugar, los trabajos por lotes mal configurados, los bucles de sondeo con un alcance deficiente y los scripts de sincronización automatizados se ejecutan silenciosamente en segundo plano. Sin mecanismos integrales de auditoría de datos, las organizaciones corren el riesgo de pagar por consultas redundantes, saturar las redes internas y agotar las reservas de la cuenta en tareas descartadas.
Auditorías de datos empresariales y el principio de minimización
En las operaciones comerciales, la fuga de recursos suele manifestarse como consultas automatizadas no gestionadas y listas de contactos desorganizadas. Los equipos técnicos suelen configurar trabajos programados que extraen bases de datos de clientes y envían tablas completas a puntos finales de terceros sin validar si cada registro requiere inspección.
La aplicación de prácticas estructuradas de auditoría de datos ayuda a las organizaciones a alinear los flujos de trabajo operativos con las normas reglamentarias y arquitectónicas. Según el GDPR Article 5 (Regulation (EU) 2016/679), el principio de minimización de datos exige que los datos personales sean adecuados, pertinentes y limitados a lo necesario en relación con los fines para los que se procesan. La realización de auditorías de datos rutinarias respalda este principio al identificar consultas automatizadas obsoletas, recortar listas de contactos desactualizadas y garantizar que las canalizaciones de validación procesen solo identificadores activos y relevantes en lugar de conjuntos de datos indiscriminados.
Arquitectura de flujos de trabajo controlados: tiempo real frente a procesamiento por lotes
Evitar el consumo descontrolado por automatización requiere seleccionar la arquitectura de procesamiento adecuada para la tarea operativa. En los flujos de trabajo de validación de Telegram, TG Validator separa la ejecución en tiempo real de las operaciones masivas asíncronas para favorecer la previsibilidad de los recursos.
Verificación en tiempo real de un solo número
El método principal para la validación bajo demanda es la Verificación de registro en Telegram en tiempo real. Este flujo de trabajo síncrono evalúa los números de teléfono enviados en formato de numeración internacional ITU-T Recommendation E.164 en el momento de la comprobación. Los equipos envían solicitudes a través de POST /api/v1/check para un solo número o POST /api/v1/batch-check para grupos síncronos de hasta 100 identificadores. En el panel web, la interfaz de Verificación por lotes en tiempo real acepta hasta 500 números pegados por ejecución. Debido a que estas comprobaciones devuelven resultados dentro de la misma sesión de solicitud, proporcionan señales inmediatas de presencia de cuenta sin generar retrasos en segundo plano.
Procesamiento de tareas masivas asíncronas
Al gestionar directorios grandes que se extienden mucho más allá de una solicitud en tiempo real, los equipos pasan a tareas masivas asíncronas utilizando POST /api/v1/bulk-tasks. En lugar de realizar llamadas a la API concurrentes y no gestionadas que corren el riesgo de tiempos de espera de conexión, los operadores envían un archivo TXT o CSV estructurado que contiene un identificador por línea. La plataforma evalúa el trabajo en segundo plano, actualizando el estado de la tarea a través de los estados processing, success o failed. Las tareas completadas generan un archivo de resultados descargable, mientras que el sondeo se limita a intervalos de no más de una vez cada 30 segundos para evitar una sobrecarga innecesaria de la API.
Controles técnicos para evitar el agotamiento descontrolado de recursos
Mantener una automatización sostenible requiere configurar barreras técnicas en torno a los límites de volumen y la supervisión del estado. Al gestionar flujos de trabajo de validación, los equipos deben aplicar los siguientes controles operativos:
Observe los límites de volumen por producto: Las tareas masivas operan bajo restricciones de volumen definidas y reglas de consistencia por país. Para las tareas masivas de números de teléfono, los archivos requieren un código de país internacional, y las tareas se rechazan si el 10% o más del archivo contiene códigos de país no coincidentes. Los equipos deben revisar la documentación oficial de la API para conocer los límites actuales por producto antes de poner en cola grandes lotes.
Respete la concurrencia por usuario: La API aplica controles de concurrencia y tiempo de espera por usuario, gestionando las comprobaciones en curso y limitando las comprobaciones múltiples para mantener la estabilidad de la plataforma. Los programadores deben cumplir con estos parámetros documentados en lugar de asumir una ejecución paralela ilimitada.
Supervise la conciliación de tareas: Las tareas masivas reservan el saldo de la cuenta en el momento del envío y concilian los cargos solo para los registros que producen resultados completados. Si una tarea falla o es rechazada, la reserva no utilizada se libera de nuevo a la cuenta. El seguimiento del historial de tareas del panel ayuda a los operadores a detectar errores de configuración antes de repetir envíos defectuosos.
Separe el registro de la identidad: TG Validator proporciona una señal de presencia de cuenta que indica si un número está registrado en Telegram en el momento de la comprobación.
Preguntas frecuentes
¿Cómo generan los sistemas automatizados sin supervisión un uso fantasma de datos?
Los procesos automatizados a menudo se ejecutan en segundo plano sin supervisión humana directa. Cuando un script automatizado encuentra respuestas de red inesperadas, registros mal formados o excepciones de software no controladas, puede activar bucles de reintento ajustados o una transmisión continua de datos. Sin un registro activo y una supervisión del uso, estos procesos consumen un ancho de banda significativo, agotan los recursos computacionales y agotan los presupuestos operativos antes de que los equipos técnicos detecten una anomalía.
¿Cuál es la diferencia operativa entre las comprobaciones en tiempo real y las tareas masivas asíncronas?
Los flujos de trabajo en tiempo real utilizan ciclos de solicitud-respuesta síncronos para inspeccionar un solo identificador o pequeños lotes durante una sesión activa, lo que los hace adecuados para la verificación bajo demanda en el punto de captura. Las tareas masivas asíncronas manejan volúmenes mayores al aceptar cargas de archivos estructurados, procesarlos en segundo plano y generar resúmenes descargables una vez completados. La separación de estas rutas de ejecución evita la congestión de solicitudes concurrentes y favorece un consumo de recursos predecible.
¿Por qué es esencial la supervisión de la auditoría de datos para los flujos de trabajo de validación de datos masivos?
Una auditoría de datos estructurada verifica que las tareas de gran volumen se ejecuten dentro de los límites esperados y solo consulten los identificadores necesarios. La supervisión de los indicadores de estado de los lotes, como los estados processing, success o failed, proporciona visibilidad sobre si los flujos de trabajo se ejecutan sin problemas o encuentran rechazos sistémicos, lo que ayuda a los equipos a corregir errores de carga útil antes de ejecutar trabajos redundantes.
Más información
Elija la información del producto que se ajuste al siguiente paso de su flujo de trabajo.