
Von Deno zu Cloudflare: Wie Infrastrukturkonsolidierung Ihren API-Workflow beeinflusst
Erfahren Sie, wie sich Infrastrukturkonsolidierung auf die API-Zuverlässigkeit auswirkt und wie Sie Concurrency, Timeouts und resiliente Workflows verwalten.
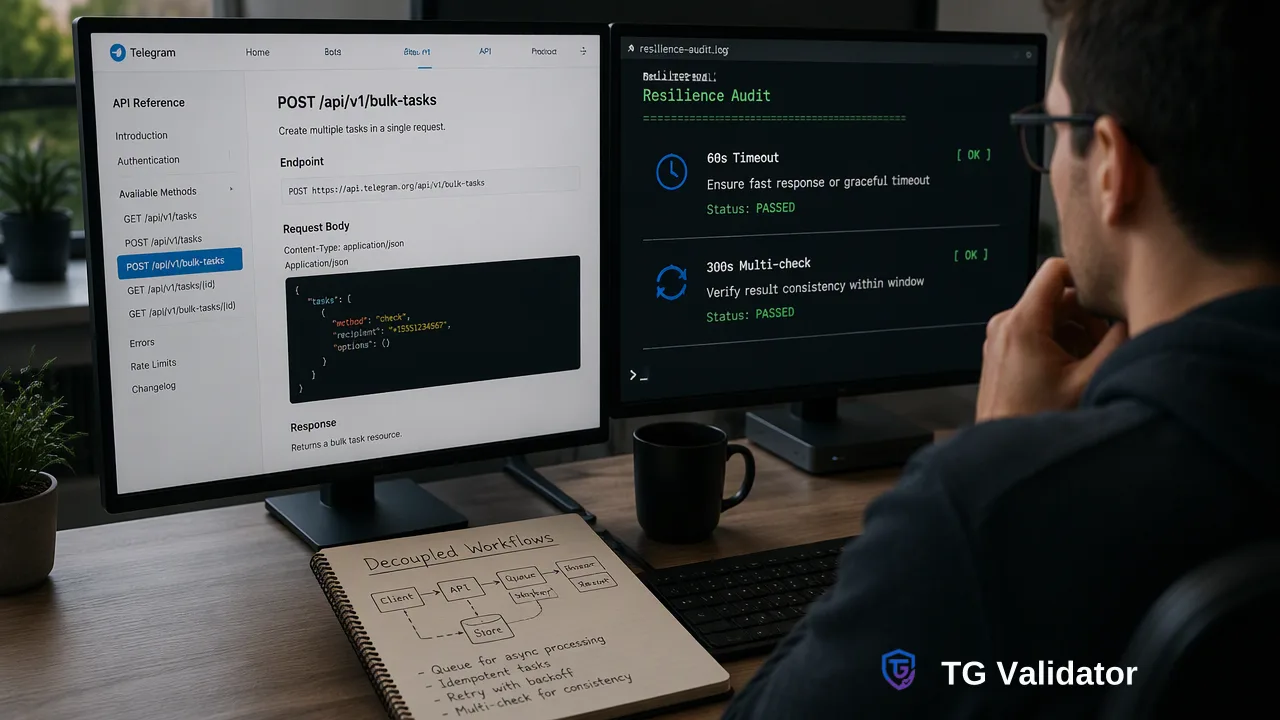
Die Infrastrukturkonsolidierung über Entwickler-Toolchains und Hosting-Plattformen hinweg unterstreicht die Notwendigkeit für resiliente Integrationsmuster. Dieser Leitfaden bietet einen technischen Audit-Rahmen, der sich auf Concurrency-Kontrollen, vorhersehbare Timeouts und entkoppelte Workflows konzentriert, um die API-Zuverlässigkeit aufrechtzuerhalten.
Die umfassende Infrastrukturkonsolidierung, wie sie durch Plattformübernahmen bei Runtimes und Hosting-Ebenen veranschaulicht wird, signalisiert einen Wandel der Branche hin zu vereinheitlichten Ausführungsumgebungen. Für Engineering-Teams bringen diese strukturellen Übergänge potenzielle Volatilität bei Upstream-Abhängigkeiten mit sich. Die Aufrechterhaltung der API-Zuverlässigkeit erfordert die Entkopplung der Geschäftslogik von zugrunde liegenden Plattformveränderungen durch explizite Concurrency-Governance, systematische Timeout-Konfigurationen und defensive Anforderungsverarbeitung. Durch die Überprüfung von Integrationsparametern und die Einhaltung dokumentierter Concurrency-Modelle etablieren Teams vorhersehbare Betriebsgrenzen, unabhängig von Veränderungen innerhalb externer Hosting-Ökosysteme.
Die Auswirkungen der Infrastrukturkonsolidierung auf die API-Zuverlässigkeit
Die strategische Konsolidierung von Entwickler-Toolchains, Ausführungs-Runtimes und verteilten Hosting-Netzwerken verändert die Annahmen, die Engineering-Teams über externe Abhängigkeiten treffen. Wenn unabhängige Plattformen zu vereinheitlichten Umgebungen verschmelzen, unterliegen die zugrunde liegenden Bereitstellungsstrukturen, das Egress-Routing und die Scheduling-Ebenen strukturellen Anpassungen. Selbst subtile Änderungen an Laufzeitumgebungen können sich nachgelagert auswirken, Jitter einführen, Verbindungs-Schwellenwerte verschieben und die Fragilität bei externen Service-Integrationen offenlegen.
Die API-Zuverlässigkeit hängt davon ab, kritische Datenpipelines von diesen umweltbedingten Verschiebungen zu isolieren. Engineering-Architekturen, die von unendlicher Bandbreite oder statischer Upstream-Latenz ausgehen, bleiben anfällig für unerwartete Verbindungsabbrüche und Engpässe bei der Warteschlangenverarbeitung. Die Entkopplung vitaler Prozesse erfordert, dass Entwickler externe Plattformverträge auf Basis ihrer dokumentierten Betriebsgrenzen bewerten, anstatt sich auf temporäre Plattformverhaltensweisen zu verlassen. Der Aufbau einer resilienten Verbindungspipeline erfordert eine strikte Schnittstellendisziplin, defensive Fehlerbehandlung und systematisches Ressourcenmanagement.
Überprüfung Ihrer Integrationsstrategie auf Systemvorhersehbarkeit
Ein umfassendes Integrations-Audit untersucht, wie Client-Services Payloads versenden, synchrone Ergebnisse verarbeiten und Fehlerdomänen isolieren. Wenn Hosting-Infrastrukturen verschmelzen, müssen Annahmen bezüglich Anforderungskontingenten und paralleler Kapazitäten neu getestet werden. Systemvorhersehbarkeit entsteht durch das Design von Integrationen, die sich unter variablen Netzwerkbedingungen konsistent verhalten.
Teams, die ihre externe Kommunikationsschicht prüfen, sollten mehrere zentrale operative Dimensionen bewerten:
Client-seitiges Concurrency-Throttling: Workflows müssen regulieren, wie viele parallele Sockets oder Worker Aufgaben gleichzeitig versenden, um plötzliche Anforderungsspitzen zu vermeiden, die ein Upstream-defensives Throttling auslösen könnten.
Granulare Ausführungsbudgets: Jede Transaktion erfordert diskrete Timeout-Schwellenwerte, die auf ihre Datenkomplexität abgestimmt sind, um sicherzustellen, dass hängende Sockets vorhersehbar beendet werden.
Deterministische Status-Analyse: Nachgelagerte Handler müssen strukturierte Antwort-Envelopes und dokumentierte Statuscodes auswerten und unerwartete Netzwerkunterbrechungen als eigenständige Workflow-Ereignisse behandeln.
Entkoppelte Datenverifizierung: Verifizierungsprüfungen – wie die Validierung von Plattform-Registrierungsdaten – sollten über standardisierte API-Abstraktionen laufen, anstatt über plattformspezifische Laufzeitabhängigkeiten.
Verwaltung von Concurrency und Timeouts für resiliente Workflows
Konkrete Integrationskontrollen sind in standardisierten Prüf-Workflows sichtbar, wie sie beispielsweise von TG Validator für die Telegram-Registrierungsprüfung bereitgestellt werden. Die öffentliche TG Validator API-Dokumentation definiert klare operative Einschränkungen, die darauf ausgelegt sind, das Systemgleichgewicht zu wahren: Jedes Benutzerkonto unterhält ein Limit von fünf laufenden Prüfungen, wobei die Timeout-Schwellenwerte auf 60 Sekunden für eine Einzelprüfung und 300 Sekunden für eine Mehrfachprüfung festgelegt sind. Zudem wird pro Konto zu jedem Zeitpunkt nur eine Mehrfachprüfung ausgeführt.
| Kontrolltyp | Dokumentierte Spezifikation | Operativer Nutzen |
|---|---|---|
| Laufende Concurrency | Maximal 5 gleichzeitige Prüfungen | Verhindert Client-seitige Socket-Erschöpfung und Serverüberlastung |
| Einzelprüfungs-Timeout | 60 Sekunden Ausführungsfenster | Gibt Client-Ressourcen zeitnah frei, falls ein Endpunkt degradiert |
| Mehrfachprüfungs-Timeout | 300 Sekunden Ausführungsfenster | Ermöglicht die vorhersehbare Auswertung von Batch-Payloads |
| Mehrfachprüfungs-Concurrency | Eine aktive Ausführung pro Konto | Sequenziert intensive Aufgaben zur Aufrechterhaltung des Systemdurchsatzes |
Anstatt ein festes Anforderungsraten-Limit pro Minute zu veröffentlichen, fordern Dienstanbieter Teams dazu auf, die aktuelle API-Dokumentation für Nutzungsrichtlinien zu konsultieren. Die Einhaltung dieser dokumentierten Concurrency-Grenzen stabilisiert den Client-Durchsatz und ermöglicht es, dass hochvolumige operative Prüfungen inmitten einer breiteren Infrastrukturentwicklung reibungslos funktionieren.
Architektonische Best Practices für Entkoppelte Workflows
Der Aufbau resilienter Systeme inmitten einer kontinuierlichen Branchenkonsolidierung erfordert die Strukturierung von Integrationen, um Upstream-Verschiebungen reibungslos zu absorbieren. Anwendungen, die Registrierungsverifizierungen oder hochfrequente Validierungssignale verarbeiten, können spezifische strukturelle Muster anwenden, um die Zuverlässigkeit zu stärken.
Trennung von synchronen und asynchronen Workloads
Direkte benutzerorientierte Interaktionen profitieren von synchronen Einzeldatensatz-Endpunkten wie POST /api/v1/check oder synchronen kleinen Batches über POST /api/v1/batch-check. Diese Aufrufe liefern unmittelbare Erreichbarkeitssignale innerhalb des dokumentierten Antwort-Envelopes. Umgekehrt sollten Hintergrund-Datenpipelines, die ein umfangreiches Volumen verarbeiten, asynchrone Aufgabenmuster übernehmen. Die Verwendung von POST /api/v1/bulk-tasks ermöglicht es Systemen, Validierungsaufträge in eine Warteschlange zu stellen, den Verarbeitungsstatus über GET /api/v1/bulk-tasks/{id} zu prüfen und umfassende Ergebnisse abzurufen, ohne Echtzeit-Anwendungs-Threads zu blockieren. Für asynchrone Aufgaben gelten produktbezogene Dateieinschränkungen und Volumenlimits, wie in der aktuellen API-Dokumentation detailliert beschrieben.
Defensive Fehlerkapselung
Externe Plattformübergänge führen häufig zu geänderten HTTP-Statuscodes oder temporären Verbindungsresets. Produktionscode sollte Upstream-Aufrufe innerhalb von Circuit-Breaker-Mustern isolieren. Wenn eine API-Prüfung einen unentschiedenen oder einen von Null verschiedenen Geschäftscode erzeugt, sollte die Anwendung die betroffene Transaktion in eine interne Überprüfungspipeline leiten, anstatt den breiteren Workflow anzuhalten. Telegram-Registrierungssignale bieten zum Zeitpunkt der Prüfung eine Verifizierung der Kontopräsenz und liefern kritische Eingaben für das Routing und Filtern, ohne dabei nicht unterstützte Annahmen über die Live-Aktivität oder die Identität des Benutzers zu treffen.
Durch die Kodierung von Concurrency-Obergrenzen, die Feinabstimmung von Timeout-Budgets und die Trennung von synchronen Prüfungen von asynchronen Datei-Jobs isolieren Engineering-Teams ihre Anwendungen von Hosting-Volatilität und stellen eine langfristige architektonische Stabilität sicher.
FAQ
Wie können Teams die API-Zuverlässigkeit während Infrastrukturübergängen sicherstellen?
Teams bewahren Stabilität, indem sie zentrale Datenoperationen hinter klaren Client-seitigen Abstraktionen isolieren. Zu den wichtigsten Taktiken gehören die Überprüfung von Upstream-Ratenparametern, die Durchsetzung strikter Client-Timeouts, die deterministische Handhabung von Antwortcodes und die Verhinderung ungebundener gleichzeitiger Ausführungen, die lokale oder entfernte Verbindungspools erschöpfen könnten.
Warum sind Concurrency-Kontrollen für die Stabilität von API-Workflows wichtig?
Concurrency-Kontrollen verhindern Anforderungsfluten und Ressourcenmangel sowohl auf der Client- als auch auf der Anbieterseite. Die Festlegung definierter Grenzwerte für laufende Anforderungen, wie beispielsweise die Verwaltung von maximal fünf gleichzeitigen Prüfungen, stabilisiert den Durchsatz, schont den Arbeitsspeicher und vermeidet kaskadierende Verbindungsfehler, wenn externe Runtimes Latenzspitzen aufweisen.
Welche Rolle spielen Timeout-Einstellungen bei der Verwaltung von API-Abhängigkeiten?
Vorhersehbare Timeouts verhindern, dass Client-Ausführungs-Threads bei nachgelagerter Netzwerkdegradierung unbegrenzt hängen bleiben. Die Differenzierung der Timeout-Dauern basierend auf der Payload-Komplexität – zum Beispiel die Zuweisung von 60 Sekunden für die Auswertung von Einzeldatensätzen und 300 Sekunden für Operationen mit mehreren Datensätzen – stellt sicher, dass Client-Systeme blockierte Ressourcen freigeben und Wiederholungsversuche sauber handhaben.
Weitere Informationen
Wählen Sie die Produktinformationen, die zum nächsten Schritt in Ihrem Workflow passen.