
От Deno к Cloudflare: как консолидация инфраструктуры влияет на рабочий процесс с API
Узнайте, как консолидация инфраструктуры влияет на надежность API, и научитесь управлять параллелизмом, тайм-аутами и отказоустойчивыми интеграциями.
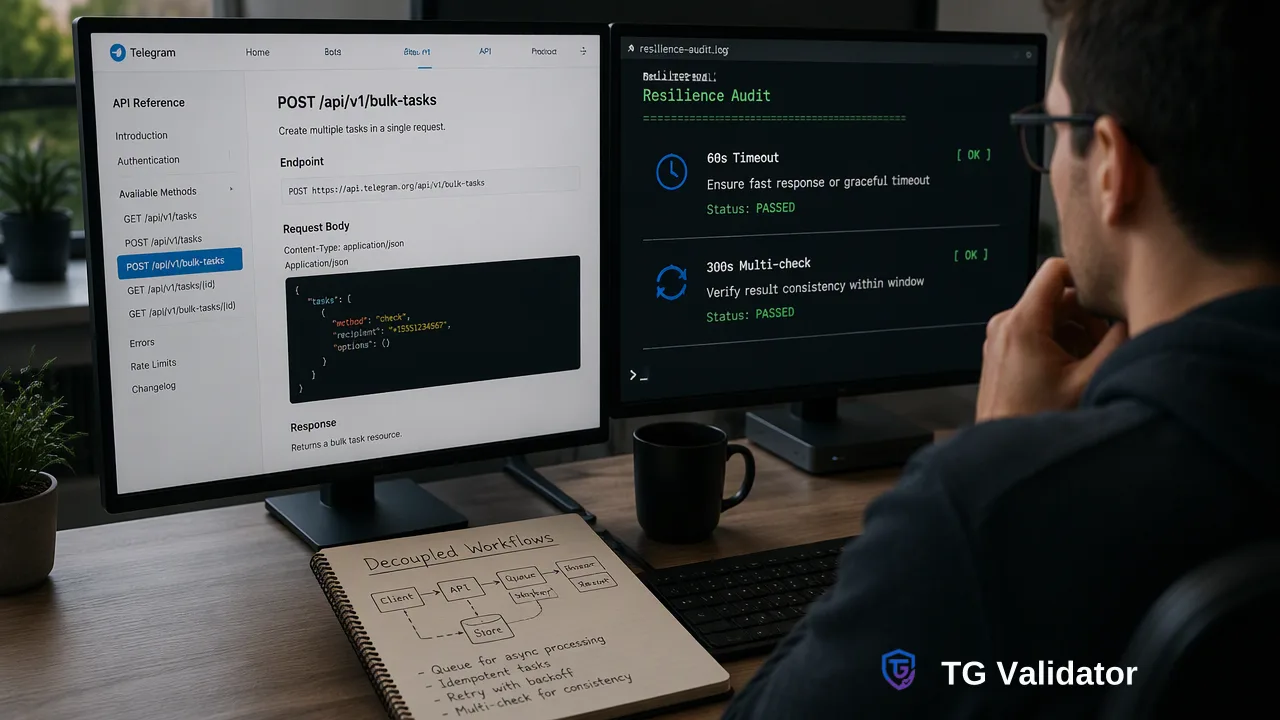
Консолидация инфраструктуры в инструментах разработки и хостинг-платформах подчеркивает необходимость использования отказоустойчивых шаблонов интеграции. В этом руководстве представлена техническая база для аудита, сфокусированная на управлении параллелизмом, предсказуемых тайм-аутах и разделении рабочих процессов для поддержания надежности API.
Масштабная консолидация инфраструктуры, примером которой служат поглощения платформ в сфере сред выполнения и хостинга, указывает на отраслевой сдвиг в сторону унифицированных сред исполнения. Для инженерных команд такие структурные переходы привносят потенциальную нестабильность в работу внешних зависимостей. Поддержание надежности API требует отделения бизнес-логики от изменений платформы посредством явного управления параллелизмом, систематической настройки тайм-аутов и защищенной обработки запросов. Проводя аудит параметров интеграции и придерживаясь документированных моделей параллелизма, команды создают предсказуемые операционные границы независимо от изменений в экосистемах внешнего хостинга.
Влияние консолидации инфраструктуры на надежность API
Стратегическая консолидация инструментов разработки, сред выполнения и распределенных хостинг-сетей меняет предположения, на которые опираются инженерные команды при работе с внешними зависимостями. Когда независимые платформы объединяются в единые среды, базовые механизмы развертывания, маршрутизация исходящего трафика и уровни планирования претерпевают структурные изменения. Даже незначительные модификации сред выполнения могут привести к каскадным эффектам, вызывая джиттер, смещение порогов соединения и обнажая уязвимости в интеграциях со сторонними сервисами.
Надежность API зависит от изоляции критически важных потоков данных от подобных изменений среды. Архитектуры, предполагающие бесконечную пропускную способность или статическую задержку вышестоящих систем, остаются уязвимыми перед неожиданными разрывами соединений и очередями запросов. Разделение жизненно важных процессов требует от разработчиков оценки контрактов внешних платформ на основе их документированных операционных границ, а не временного поведения платформы. Создание отказоустойчивого канала связи требует строгой дисциплины интерфейсов, защищенной обработки ошибок и систематического управления ресурсами.
Аудит стратегии интеграции для обеспечения предсказуемости системы
Комплексный аудит интеграции исследует то, как клиентские сервисы отправляют полезную нагрузку, обрабатывают синхронные результаты и изолируют домены сбоев. При слиянии хостинг-инфраструктур предположения относительно квот на запросы и возможностей параллельной обработки должны быть перепроверены. Предсказуемость системы возникает из проектирования интеграций, которые ведут себя согласованно в условиях переменной сетевой нагрузки.
Командам, проводящим аудит уровня внешних коммуникаций, следует оценить несколько ключевых операционных аспектов:
Ограничение параллелизма на стороне клиента: рабочие процессы должны регулировать количество параллельных сокетов или воркеров, отправляющих задачи одновременно, чтобы избежать резких скачков запросов, вызывающих защитное ограничение скорости со стороны вышестоящей системы.
Гранулярные бюджеты выполнения: каждая транзакция требует отдельных порогов тайм-аута, соответствующих сложности данных, что гарантирует предсказуемое завершение зависших сокетов.
Детерминированный парсинг статусов: обработчики должны оценивать структурированные конверты ответов и документированные коды статусов, рассматривая неожиданные сетевые прерывания как отдельные события рабочего процесса.
Разделенная верификация данных: проверки верификации, такие как проверка данных регистрации на платформе, должны выполняться через стандартизированные абстракции API, а не через специфические для платформы зависимости среды выполнения.
Управление параллелизмом и тайм-аутами для отказоустойчивых рабочих процессов
Конкретные средства контроля интеграции видны в стандартизированных рабочих процессах проверки, таких как те, что предоставляются TG Validator для верификации аккаунтов Telegram. Публичная документация TG Validator API определяет четкие операционные ограничения, призванные сохранить баланс системы: каждый пользовательский аккаунт поддерживает лимит в пять активных проверок одновременно, с порогами тайм-аута 60 секунд для одиночной проверки и 300 секунд для мульти-проверки. Кроме того, для каждого аккаунта в любой момент времени может выполняться только одна мульти-проверка.
| Тип контроля | Документированная спецификация | Операционное преимущество |
|---|---|---|
| Параллелизм активных запросов | Максимум 5 одновременных проверок | Предотвращает исчерпание сокетов на стороне клиента и перегрузку сервера |
| Тайм-аут одиночной проверки | Окно выполнения 60 секунд | Быстро освобождает клиентские ресурсы при деградации эндпоинта |
| Тайм-аут мульти-проверки | Окно выполнения 300 секунд | Обеспечивает предсказуемую оценку пакетной полезной нагрузки |
| Параллелизм мульти-проверки | Одно активное выполнение на аккаунт | Упорядочивает интенсивные задачи для поддержания пропускной способности системы |
Вместо публикации фиксированного лимита запросов в минуту, поставщики услуг требуют, чтобы команды обращались к текущей документации API для ознакомления с политиками использования. Соблюдение этих документированных границ параллелизма стабилизирует пропускную способность клиента, позволяя операционным проверкам с большим объемом данных функционировать бесперебойно на фоне более широкой эволюции инфраструктуры.
Архитектурные рекомендации для разделенных рабочих процессов
Создание отказоустойчивых систем в условиях постоянной консолидации отрасли требует структурирования интеграций таким образом, чтобы они плавно поглощали изменения вышестоящих систем. Приложения, обрабатывающие верификацию регистрации или высокочастотные сигналы валидации, могут применять специфические структурные шаблоны для повышения надежности.
Разделение синхронных и асинхронных рабочих нагрузок
Взаимодействие, ориентированное на пользователя, выигрывает от использования синхронных эндпоинтов для отдельных записей, таких как POST /api/v1/check, или синхронных небольших пакетов через POST /api/v1/batch-check. Эти вызовы предоставляют немедленные сигналы доступности в рамках документированного конверта ответа. И наоборот, фоновые потоки данных, обрабатывающие значительные объемы, должны использовать шаблоны асинхронных задач. Использование POST /api/v1/bulk-tasks позволяет системам ставить задачи валидации в очередь, проверять статус обработки через GET /api/v1/bulk-tasks/{id} и получать полные результаты, не занимая потоки приложения в реальном времени. К асинхронным задачам применяются ограничения по файлам и объемам для каждого продукта, как подробно описано в текущей документации API.
Защищенная инкапсуляция ошибок
Переходы между внешними платформами часто приводят к изменению кодов состояния HTTP или временным сбросам соединений. Промышленный код должен изолировать вызовы вышестоящих систем с помощью шаблонов автоматических выключателей (circuit-breaker). Когда проверка API выдает неопределенный или ненулевой бизнес-код, приложение должно направлять затронутую транзакцию в конвейер внутренней проверки, а не останавливать рабочий процесс целиком. Сигналы регистрации в Telegram обеспечивают верификацию присутствия аккаунта на момент проверки, предоставляя критически важные данные для маршрутизации и фильтрации без необоснованных предположений относительно активности пользователя в сети или его личности.
Кодифицируя ограничения параллелизма, настраивая бюджеты тайм-аутов и разделяя синхронные проверки и асинхронные файловые задачи, инженерные команды защищают свои приложения от волатильности хостинга и обеспечивают долгосрочную архитектурную стабильность.
Часто задаваемые вопросы
Как команды могут обеспечить надежность API во время инфраструктурных переходов?
Команды поддерживают стабильность, изолируя основные операции с данными за четкими клиентскими абстракциями. Ключевые тактики включают аудит параметров скорости вышестоящих систем, принудительное соблюдение строгих тайм-аутов клиента, детерминированную обработку кодов ответов и предотвращение неограниченного параллельного выполнения, которое может исчерпать локальные или удаленные пулы соединений.
Почему контроль параллелизма важен для стабильности рабочего процесса API?
Контроль параллелизма предотвращает перегрузку запросами и истощение ресурсов как на стороне клиента, так и на стороне поставщика. Установление определенных лимитов на активные запросы, например, управление максимум пятью одновременными проверками, стабилизирует пропускную способность, сохраняет память и предотвращает каскадные сбои соединений при возникновении скачков задержки во внешних средах выполнения.
Какую роль играют настройки тайм-аута в управлении зависимостями API?
Предсказуемые тайм-ауты предотвращают бесконечное зависание потоков выполнения клиента при деградации сети на стороне вышестоящей системы. Разграничение длительности тайм-аутов в зависимости от сложности полезной нагрузки — например, выделение 60 секунд для оценки отдельных записей и 300 секунд для операций с несколькими записями — гарантирует, что клиентские системы освобождают заблокированные ресурсы и корректно выполняют повторные попытки.
Узнайте больше
Выберите информацию о продукте, которая соответствует следующему шагу в вашем рабочем процессе.