
De Deno a Cloudflare: Cómo la consolidación de infraestructura afecta su flujo de trabajo de API
Descubra cómo la consolidación de infraestructura afecta la fiabilidad de la API y aprenda a gestionar la concurrencia, los tiempos de espera y los flujos de trabajo.
La consolidación de infraestructura en las cadenas de herramientas de desarrollo y las plataformas de alojamiento subraya la necesidad de patrones de integración resilientes. Esta guía proporciona un marco de auditoría técnica centrado en controles de concurrencia, tiempos de espera predecibles y flujos de trabajo desacoplados para mantener la fiabilidad de la API.
La consolidación importante de la infraestructura, ejemplificada por las adquisiciones de plataformas en entornos de ejecución y capas de alojamiento, señala un cambio en la industria hacia entornos de ejecución unificados. Para los equipos de ingeniería, estas transiciones estructurales introducen una volatilidad potencial en las dependencias ascendentes. Mantener la fiabilidad de la API requiere desacoplar la lógica de negocio de los cambios en la plataforma subyacente mediante una gobernanza explícita de la concurrencia, configuraciones sistemáticas de tiempos de espera y un manejo defensivo de las solicitudes. Al auditar los parámetros de integración y adherirse a los modelos de concurrencia documentados, los equipos establecen límites operativos predecibles independientemente de los cambios dentro de los ecosistemas de alojamiento externos.
El impacto de la consolidación de infraestructura en la fiabilidad de la API
La consolidación estratégica de las cadenas de herramientas de desarrollo, los entornos de ejecución y las redes de alojamiento distribuidas altera las suposiciones que los equipos de ingeniería hacen sobre las dependencias externas. Cuando las plataformas independientes se fusionan en entornos unificados, las estructuras de despliegue, el enrutamiento de salida y las capas de programación subyacentes experimentan ajustes estructurales. Incluso modificaciones sutiles en los entornos de ejecución pueden propagarse hacia abajo, introduciendo fluctuaciones, desplazando los umbrales de conexión y exponiendo la fragilidad en las integraciones de servicios externos.
La fiabilidad de la API depende de aislar los flujos de datos críticos de estos cambios ambientales. Las arquitecturas de ingeniería que asumen un ancho de banda infinito o una latencia ascendente estática siguen siendo vulnerables a caídas de conexión inesperadas y cuellos de botella en las colas. El desacoplamiento de procesos vitales requiere que los desarrolladores evalúen los contratos de las plataformas externas basándose en sus límites operativos documentados en lugar de en comportamientos temporales de la plataforma. Establecer una canalización de conexión resiliente requiere una disciplina de interfaz estricta, captura defensiva de errores y gestión sistemática de recursos.
Auditoría de su estrategia de integración para la previsibilidad del sistema
Una auditoría de integración integral examina cómo los servicios cliente envían cargas útiles, procesan resultados síncronos y aíslan los dominios de falla. Cuando las infraestructuras de alojamiento se fusionan, las suposiciones sobre las cuotas de solicitud y la capacidad paralela deben volver a probarse. La previsibilidad del sistema surge del diseño de integraciones que se comportan de manera consistente bajo condiciones de red variables.
Los equipos que auditan su capa de comunicación externa deben evaluar varias dimensiones operativas fundamentales:
Limitación de concurrencia del lado del cliente: Los flujos de trabajo deben regular cuántos sockets o trabajadores paralelos envían tareas simultáneamente, evitando picos repentinos de solicitudes que activen la limitación defensiva ascendente.
Presupuestos de ejecución granulares: Cada transacción requiere umbrales de tiempo de espera discretos adaptados a su complejidad de datos, asegurando que los sockets bloqueados terminen de manera predecible.
Análisis determinista de estados: Los controladores descendentes deben evaluar los sobres de respuesta estructurados y los códigos de estado documentados, tratando las interrupciones de red inesperadas como eventos de flujo de trabajo distintos.
Verificación de datos desacoplada: Las comprobaciones de verificación, como la validación de datos de registro en la plataforma, deben ejecutarse a través de abstracciones de API estandarizadas en lugar de dependencias de tiempo de ejecución específicas de la plataforma.
Gestión de la concurrencia y tiempos de espera para flujos de trabajo resilientes
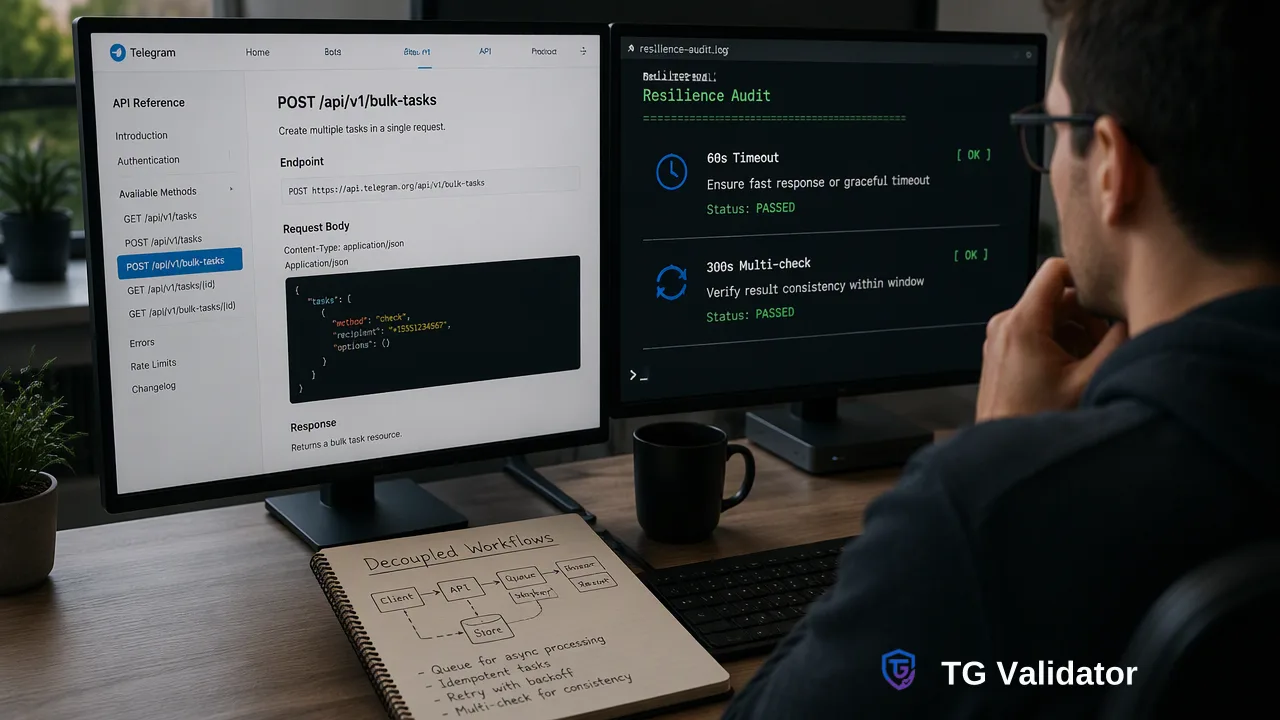
Los controles de integración concretos son visibles en los flujos de trabajo de verificación estandarizados, como los proporcionados por TG Validator para la verificación de cuentas de Telegram. La documentación pública de la API de TG Validator define límites operativos claros diseñados para preservar el equilibrio del sistema: cada cuenta de usuario mantiene un límite de cinco comprobaciones en curso, con umbrales de tiempo de espera establecidos en 60 segundos para una comprobación única y 300 segundos para una comprobación múltiple. Además, solo se ejecuta una comprobación múltiple por cuenta en cualquier momento dado.
| Tipo de control | Especificación documentada | Beneficio operativo |
|---|---|---|
| Concurrencia en curso | Máximo de 5 comprobaciones simultáneas | Evita el agotamiento de sockets del lado del cliente y la sobrecarga del servidor |
| Tiempo de espera de comprobación única | Ventana de ejecución de 60 segundos | Libera recursos del cliente rápidamente si un punto final se degrada |
| Tiempo de espera de comprobación múltiple | Ventana de ejecución de 300 segundos | Acomoda las evaluaciones de carga útil por lotes de forma predecible |
| Concurrencia de comprobación múltiple | Ejecución activa única por cuenta | Secuencia tareas intensivas para mantener el rendimiento del sistema |
En lugar de publicar un límite de tasa de solicitudes por minuto fijo, los proveedores de servicios requieren que los equipos consulten la documentación actual de la API para conocer las políticas de uso. Adherirse a estos límites de concurrencia documentados estabiliza el rendimiento del cliente, permitiendo que las comprobaciones operativas de alto volumen funcionen sin problemas en medio de una evolución más amplia de la infraestructura.
Mejores prácticas arquitectónicas para flujos de trabajo desacoplados
Construir sistemas resilientes en medio de la consolidación continua de la industria requiere estructurar las integraciones para absorber los cambios ascendentes sin problemas. Las aplicaciones que procesan verificaciones de registro o señales de validación de alta frecuencia pueden aplicar patrones estructurales específicos para reforzar la fiabilidad.
Separación de cargas de trabajo síncronas y asíncronas
Las interacciones directas con el usuario se benefician de puntos finales síncronos de registro único como POST /api/v1/check o pequeños lotes síncronos mediante POST /api/v1/batch-check. Estas llamadas producen señales de alcanzabilidad inmediatas dentro del sobre de respuesta documentado. Por el contrario, las canalizaciones de datos en segundo plano que manejan un volumen extenso deben adoptar patrones de tareas asíncronas. El uso de POST /api/v1/bulk-tasks permite a los sistemas poner en cola trabajos de validación, verificar el estado del procesamiento a través de GET /api/v1/bulk-tasks/{id} y recuperar resultados completos sin bloquear los hilos de la aplicación en tiempo real. Los límites de archivo y volumen por producto se aplican a las tareas asíncronas, como se detalla en la documentación actual de la API.
Encapsulación defensiva de errores
Las transiciones de plataformas externas introducen frecuentemente códigos de estado HTTP alterados o restablecimientos de conexión temporales. El código de producción debe aislar las llamadas ascendentes dentro de patrones de disyuntor. Cuando una comprobación de API produce un código de negocio indeciso o distinto de cero, la aplicación debe enrutar la transacción afectada a una canalización de revisión interna en lugar de detener el flujo de trabajo más amplio. Las señales de registro de Telegram proporcionan verificación de presencia de cuenta en el momento de la comprobación, ofreciendo información crítica para el enrutamiento y filtrado sin hacer suposiciones no respaldadas sobre la actividad del usuario en vivo o la identidad del usuario.
Al codificar límites de concurrencia, ajustar presupuestos de tiempo de espera y separar las comprobaciones síncronas de los trabajos de archivos asíncronos, los equipos de ingeniería aíslan sus aplicaciones de la volatilidad del alojamiento y garantizan la estabilidad arquitectónica a largo plazo.
Preguntas frecuentes
¿Cómo pueden los equipos garantizar la fiabilidad de la API durante las transiciones de infraestructura?
Los equipos mantienen la estabilidad aislando las operaciones de datos principales detrás de abstracciones claras del lado del cliente. Las tácticas clave incluyen auditar los parámetros de tasa ascendentes, aplicar tiempos de espera estrictos al cliente, manejar los códigos de respuesta de forma determinista y evitar que la ejecución concurrente sin límites agote los grupos de conexiones locales o remotos.
¿Por qué son importantes los controles de concurrencia para la estabilidad del flujo de trabajo de la API?
Los controles de concurrencia evitan la saturación de solicitudes y el agotamiento de recursos tanto en el lado del cliente como en el del proveedor. Establecer límites definidos en las solicitudes en curso, como gestionar un máximo de cinco comprobaciones simultáneas, estabiliza el rendimiento, preserva la memoria y evita fallos de conexión en cascada cuando los entornos de ejecución externos experimentan picos de latencia.
¿Qué papel desempeñan los ajustes de tiempo de espera en la gestión de las dependencias de la API?
Los tiempos de espera predecibles evitan que los hilos de ejecución del cliente se bloqueen indefinidamente durante la degradación de la red descendente. Diferenciar las duraciones de tiempo de espera según la complejidad de la carga útil (por ejemplo, asignar 60 segundos para evaluaciones de registro único y 300 segundos para operaciones de registro múltiple) garantiza que los sistemas cliente liberen los recursos bloqueados y manejen los reintentos de forma limpia.
Más información
Elija la información del producto que se ajuste al siguiente paso en su flujo de trabajo.